当基准测试说赢了,但生产环境说等不起
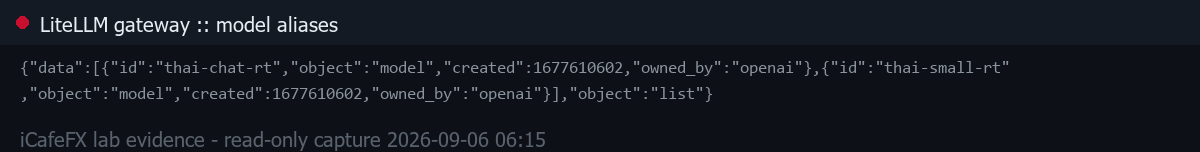
我曾经相信屏幕上漂亮的数字总能转化为实际成果,但昨天它又给我上了一堂昂贵的课。故事始于一个看似极其合理的想法:把客服聊天机器人搬到家里的 Mac Mini M4 Pro 上运行,以降低成本并提高隐私性,不再依赖我们长期使用的 z.ai 等外部云服务。在受控环境(基准测试)中,新模型的正确性得分达到 8.40,明显高于旧版本的 7.68。乍一看,这是一次重大胜利,但真实战场上的情况却截然不同。
速度从未与长度同行
主要问题不在于模型的智能程度,而在于"延迟"——响应时间的滞后。我让模型读取长达 6,928 token 的提示词,以涵盖复杂的黄金分析和交易信号上下文。结果是预填充速度约为每秒 115 token,听起来还不错,但乘以需要处理的 token 数量后,客户在收到第一个回答前必须等待超过 85 秒。对于期望实时回答的交易客服系统而言,仅仅几秒的延迟就可能意味着错失盈利或亏损的时机。光是开始对话就要等将近一个半分钟,在外汇行业——每一秒都价值连城——这是完全不可接受的。
失败背后的数字
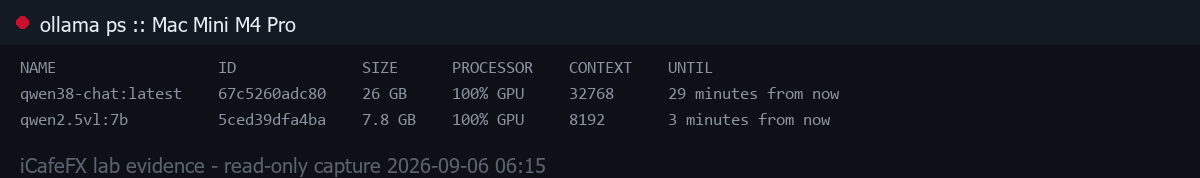
看看 2026 年 9 月 6 日 Mac Mini M4 Pro 上的实际数据,情况会更加清晰。25 GB 的 qwen38-chat:latest 模型让 GPU 满载运行至 100%,上下文高达 32,768 token。而系统中其他 16GB 显卡的机器同样不堪重负,内存几乎用尽:一台占用了 16,311 MiB 中的 15,745 MiB,另一台占用了 16,311 MiB 中的 14,475 MiB。这表明资源已被榨干,但用户体验却急剧下降。GPU 满载运行 100% 并不意味着系统一定快,有时它恰恰意味着瓶颈导致一切停滞。
来自 4,028 条记录的教训
最痛苦的是不得不立即决定回滚到 z.ai。尽管测试表明新模型更优,但在生产环境中,我们不能拿客户体验的恶化去冒险。我检查了日志,发现有 4,028 条对话记录受到了这次延迟的影响。回归旧系统并非认输,而是承认"基准测试"与"生产环境"是两个不同的世界。在基准测试中,我们测量的是静态条件下的正确性和效率;而在生产环境中,我们衡量的是在不断变化的真实工作负载下的稳定性和速度。执着于 8.40 这个数字而忽视用户体验的全貌,让我差点犯下严重错误。
下一步:为速度而精简
从这次事件中,我学到长提示词并非总是答案。有时,删减不必要的数据以提升模型处理速度,比试图把所有东西塞进大上下文更值得。我的下一步计划是设计一个将信号分析部分与对话部分分离的系统,让聊天机器人使用简短的提示词回答一般性问题,仅在需要计算复杂数字时才调用专用模型。承认最好的技术并不意味着适用于所有场景,是 iCafeFX 和 SiamCafe 成长的重要一步。
我依然相信 AI 的力量,但必须学会明智地使用它,而不是盲目追随潮流或屏幕上的漂亮数字。最残酷的真相是:客户不关心你的模型得了多少分,他们只在乎是否得到了足够快且足够准确的回答。因此,后续的系统调优将把降低延迟放在首位,让技术为人服务,而不是让人等技术。