ベンチマークは勝利を示すが、本番環境は待てないと言う
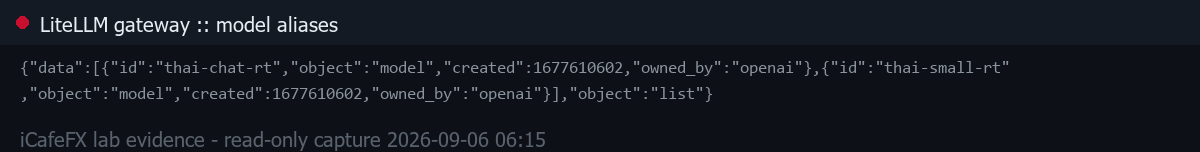
私は美しい数字が常に実際の結果に結びつくと思っていた。しかし昨日は、再び高価な教訓を私に教えてくれた。話は非常に理にかなったアイデアから始まった。取引顧客対応チャットボットを自宅のMac Mini M4 Proで動作させ、コスト削減とプライバシー向上を図るというもので、長年使用してきたz.aiのような外部クラウドサービスへの依存を減らすというものである。制御された環境でのテスト(ベンチマーク)では、新しいモデルは正確性スコア8.40を示し、旧バージョンの7.68を明確に上回った。一見すると大きな勝利のように見えたが、実際の戦場での現実とは全く異なるものだった。
長さと伴わない速度
主な問題はモデルの知能ではなく、「レイテンシ」、すなわち応答の遅延だった。私はゴールド分析と複雑な取引シグナルの文脈をカバーするために、6,928トークンの長いプロンプトを与えようとした。その結果、プリフィル速度は約115トークン/秒で、悪くはないように聞こえるが、最初の質問に答える前に処理しなければならないトークン数と掛け合わせると、顧客は85秒以上待つ必要があった。取引においてリアルタイムの回答を期待する顧客にとって、わずか数秒の遅延でも利益の機会を逃すか損失を意味する可能性がある。会話を開始するだけでほぼ1分半待つことは、1秒が価値を持つForex業界では許容できない。
失敗の背後にある数字
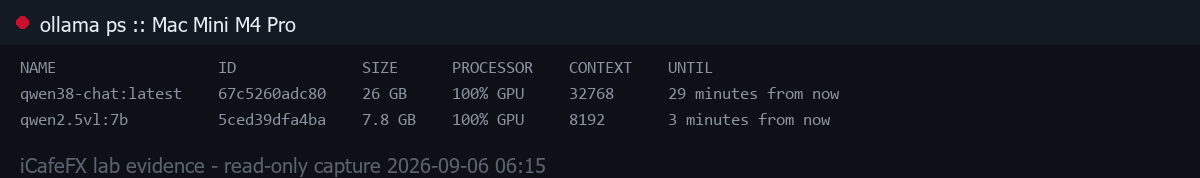
2026年9月6日のMac Mini M4 Proからの実際のデータを見てみよう。25GBのモデルqwen38-chat:latestはGPUを100%フル稼働で動作し、最大32,768トークンのコンテキストを処理していた。一方、他のシステムの16GBグラフィックカードも同様に重労働で、メモリをほぼ完全に使用していた(16,311 MiB中15,745 MiB、もう一台は16,311 MiB中14,475 MiB)。これはリソースが完全に使い果たされたことを示しているが、ユーザーへの応答効率は驚くほど低下していた。GPUが100%稼働しているからといってシステムが速いわけではない。時にはそれはすべてを停滞させるボトルネックを意味する。
4,028行のLedgerからの教訓
最も痛かったのは、すぐにz.aiへのロールバックを決定しなければならなかったことだ。テストでは新しいモデルの方が優れていると言っていたが、本番環境では顧客体験が悪化するリスクを負うことはできなかった。ログを確認すると、この遅延の影響を受けた会話記録が4,028行あることがわかった。元のシステムに戻ることは敗北ではなく、「ベンチマーク」と「本番環境」は別世界であることを受け入れることだった。ベンチマークでは静的な条件下での正確性と効率を測定するが、本番環境では常に変化する実際の負荷下での安定性と速度を測定する。8.40という数字に固執してユーザー体験全体を見なかったことが、重大な間違いを犯すところだった。
次の解決策:速度のための切り捨て
この出来事から、長いプロンプトが常に答えではないことを学んだ。時にはモデルの処理を速くするために不要なデータを切り捨てる方が、すべてを大きなコンテキストに押し込めようとするよりも価値があるかもしれない。私の次の計画は、シグナル分析部分を会話部分と分離するシステムを設計することだ。これによりチャットボットは一般的な質問には短くて簡潔なプロンプトを使用し、複雑な計算が必要な場合にのみ専門モデルを呼び出すようにする。最良の技術がすべての状況に最良であるわけではないことを受け入れることは、iCafeFXとSiamCafeの成長における重要な一歩だ。
私はまだAIの力を信じているが、賢く使う方法を学ばなければならない。単にトレンドや画面の美しい数字に従うだけではいけない。最も残酷な真実は、顧客はあなたのモデルが何点を取ったか気にしないということだ。彼らが気にするのは、十分に速く、十分に正確な回答を受け取れるかどうかだけだ。今後のシステム調整はレイテンシ削減を最優先とし、技術が人々のために働くようにし、人が技術を待つようにしないことに集中する。