벤치마크는 이겼지만, 프로덕션은 기다릴 수 없었다
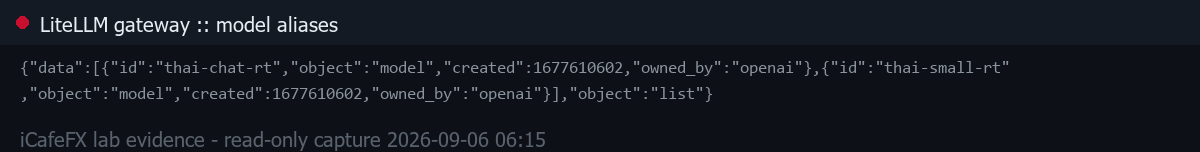
나는 예쁘게 보이는 숫자가 항상 실제 결과로 이어진다고 믿었다. 하지만 어제 그 믿음은 다시 한번 값비싼 교훈을 주었다. 이야기는 매우 합리적으로 보였던 아이디어에서 시작되었다. 트레이딩 고객 서비스 챗봇을 외부 클라우드 서비스인 z.ai 대신 내 집의 Mac Mini M4 Pro로 옮겨 실행하는 것이었다. 비용 절감과 프라이버시 강화가 목적이었다. 통제된 환경에서의 테스트(벤치마크)는 새로운 모델이 정확도 8.40점을 얻어 기존 버전의 7.68점을 명확하게 앞선다고 보고했다. 겉보기에는 큰 승리였다. 하지만 실제 전장의 현실은 완전히 달랐다.
길이에 비례하지 않는 속도
주된 문제는 모델의 지능이 아니라 "지연 시간(Latency)"이었다. 나는 금 분석과 복잡한 트레이딩 신호에 대한 컨텍스트를 포함하기 위해 6,928 토큰에 달하는 긴 프롬프트를 모델에 입력했다. 결과는 프리필 속도가 초당 약 115 토큰으로, 나쁘지 않아 보일 수 있었다. 하지만 처리해야 할 토큰 수와 곱해지면 첫 답변까지 85초 이상을 기다려야 했다. 실시간 트레이딩 답변을 기대하는 고객에게 몇 초의 지연도 이익 기회를 놓치거나 손실을 의미할 수 있다. 대화 시작만 거의 1분 반을 기다리는 것은 모든 초가 중요한 Forex 업계에서는 용납될 수 없는 일이었다.
실패 뒤에 숨은 숫자들
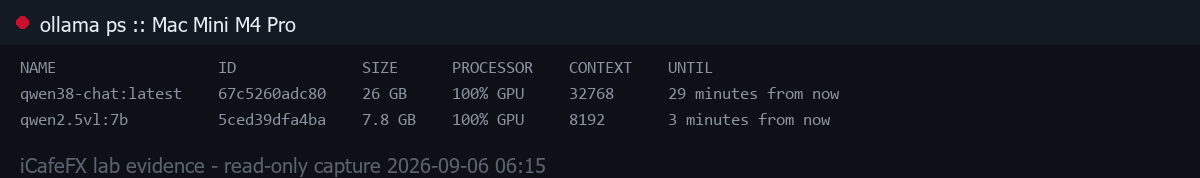
2026년 9월 6일 Mac Mini M4 Pro의 실제 데이터를 보면 상황이 더 명확해진다. 25GB 크기의 qwen38-chat:latest 모델이 GPU를 100% 사용하며 최대 32,768 토큰의 컨텍스트로 실행되었다. 다른 시스템의 16GB GPU도 마찬가지로 과부하 상태였다. 메모리 사용량은 16,311 MiB 중 15,745 MiB, 또 다른 시스템은 16,311 MiB 중 14,475 MiB를 사용했다. 이는 자원이 완전히 소진되었지만 사용자 응답 성능은 놀라울 정도로 떨어졌다는 것을 보여준다. GPU가 100%로 작동한다고 해서 시스템이 항상 빠른 것은 아니다. 때로는 모든 것을 멈추게 하는 병목 현상을 의미하기도 한다.
4,028행의 로그에서 얻은 교훈
가장 아픈 결정은 즉시 z.ai로 롤백하는 것이었다. 테스트는 새로운 모델이 더 좋다고 말했지만, 프로덕션에서는 고객 경험의 저하를 감수할 수 없었다. 로그를 확인해보니 이 지연으로 영향을 받은 대화 기록이 4,028행에 달했다. 원래 시스템으로 돌아가는 것은 패배가 아니라 "벤치마크"와 "프로덕션"이 서로 다른 세계라는 것을 인정하는 것이었다. 벤치마크에서는 정적 상태에서의 정확성과 효율성을 측정하지만, 프로덕션에서는 끊임없이 변화하는 실제 부하 하에서의 안정성과 속도를 측정한다. 8.40이라는 숫자에 집착하고 사용자 경험의 전체적인 그림을 보지 못해 거의 심각한 실수를 저지를 뻔했다.
다음 단계: 속도를 위한 절단
이 사건을 통해 나는 긴 프롬프트가 항상 해답이 아니라는 것을 배웠다. 때로는 불필요한 정보를 잘라내어 모델이 더 빠르게 처리하게 하는 것이 모든 것을 큰 컨텍스트에 집어넣으려는 시도보다 더 가치있을 수 있다. 다음 계획은 신호 분석 부분을 대화 부분과 분리하는 시스템을 설계하는 것이다. 챗봇은 일반적인 질문에 대해 짧은 프롬프트를 사용하고, 복잡한 숫자 계산이 필요할 때만 전문 모델을 호출하도록 한다. 최고의 기술이 모든 상황에 가장 좋은 것은 아니라는 것을 인정하는 것이 iCafeFX와 SiamCafe의 성장에 중요한 단계이다.
나는 여전히 AI의 힘을 믿지만, 단순히 트렌드나 화면 위의 예쁜 숫자를 따라가는 것이 아니라 지혜롭게 사용해야 한다는 것을 배워야 한다. 가장 잔인한 진실은 고객이 당신의 모델이 어떤 점수를 받았는지 신경 쓰지 않는다는 것이다. 그들은 단지 충분히 빠르고 정확한 답변을 받는지만 관심 있다. 따라서 시스템 튜닝의 다음 단계는 지연 시간 감소를 최우선으로 하여, 기술이 사람을 위해 작동하도록 하고 사람이 기술을 기다리지 않도록 하는 데 초점을 맞추고 있다.