Khi benchmark nói thắng, nhưng production nói không thể chờ
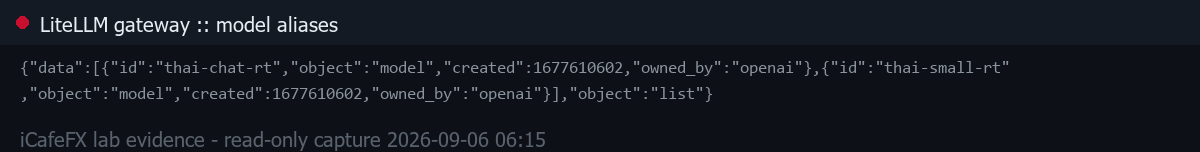
Tôi từng tin rằng những con số đẹp trên màn hình sẽ luôn dịch chuyển thành kết quả thực tế. Nhưng ngày hôm qua, nó lại dạy tôi một bài học đắt giá. Câu chuyện bắt đầu từ một ý tưởng nghe rất hợp lý: di chuyển chatbot hỗ trợ khách hàng giao dịch sang chạy trên Mac Mini M4 Pro tại nhà để giảm chi phí và tăng tính riêng tư, thay vì dựa vào dịch vụ đám mây bên ngoài như z.ai mà chúng tôi đã dùng lâu nay. Benchmark trong môi trường kiểm soát cho thấy mô hình mới đạt điểm chính xác 8.40, vượt xa phiên bản cũ là 7.68. Nhìn thoáng qua, đây là một chiến thắng lớn. Nhưng thực tế trên chiến trường production lại hoàn toàn khác.
Tốc độ không đi kèm với chiều dài
Vấn đề chính không phải là sự thông minh của mô hình, mà là "latency" - độ trễ phản hồi. Tôi thử cho mô hình đọc prompt dài tới 6.928 token để bao phủ ngữ cảnh phân tích vàng và tín hiệu giao dịch phức tạp. Kết quả là tốc độ prefill chỉ khoảng 115 token/giây, nghe có vẻ không tệ. Nhưng khi nhân với số token cần xử lý trước khi trả lời câu hỏi đầu tiên, khách hàng phải chờ hơn 85 giây. Đối với hệ thống mà khách hàng mong đợi phản hồi real-time trong giao dịch, chỉ vài giây chậm trễ cũng có thể đồng nghĩa với bỏ lỡ cơ hội sinh lời hoặc chịu lỗ. Chờ gần một phút rưỡi chỉ để bắt đầu cuộc trò chuyện là điều không thể chấp nhận được trong ngành Forex, nơi mỗi giây đều có giá trị.
Những con số phía sau thất bại
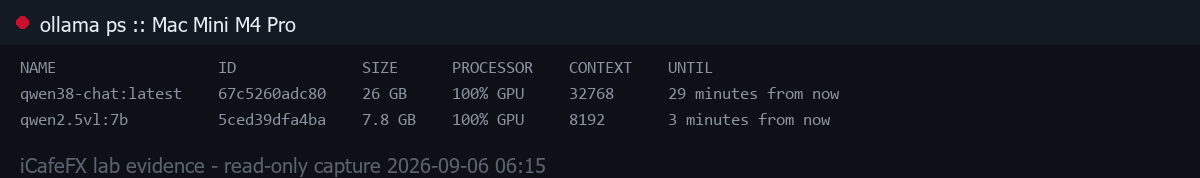
Hãy xem dữ liệu thực tế từ Mac Mini M4 Pro ngày 6/9/2026 để thấy rõ hơn. Mô hình qwen38-chat:latest kích thước 25GB chạy hết công suất GPU 100% với context lên tới 32.768 token. Trong khi đó, card đồ họa 16GB của hệ thống khác cũng hoạt động hết sức, sử dụng gần hết bộ nhớ như 15.745/16.311 MiB và máy khác là 14.475/16.311 MiB. Điều này cho thấy tài nguyên đã được dùng hết mức, nhưng hiệu suất phản hồi người dùng lại giảm đáng kinh ngạc. GPU chạy 100% không có nghĩa là hệ thống nhanh - đôi khi nó chỉ có nghĩa là một nút thắt cổ chai (bottleneck) khiến mọi thứ ì ạch.
Bài học từ 4.028 dòng ledger
Điều đau đớn nhất là phải quyết định rollback ngay lập tức về z.ai. Dù benchmark nói mô hình mới tốt hơn, nhưng trong production, chúng tôi không thể mạo hiểm với trải nghiệm khách hàng kém đi. Tôi kiểm tra log và phát hiện có tới 4.028 dòng hội thoại bị ảnh hưởng bởi độ trễ này. Quay lại hệ thống cũ không phải là đầu hàng, mà là thừa nhận rằng "benchmark" và "production" là hai thế giới khác nhau. Benchmark đo chính xác và hiệu suất trong điều kiện tĩnh, nhưng production đo sự ổn định và tốc độ dưới tải thực tế thay đổi liên tục. Nắm chặt con số 8.40 thay vì nhìn tổng thể trải nghiệm người dùng đã khiến tôi suýt mắc sai lầm nghiêm trọng.
Giải pháp tiếp theo: Cắt giảm để tăng tốc
Từ sự việc này, tôi học được rằng prompt dài không phải lúc nào cũng là câu trả lời. Đôi khi, cắt bỏ thông tin không cần thiết để mô hình xử lý nhanh hơn có thể đáng giá hơn cố nhét mọi thứ vào context lớn. Kế hoạch tiếp theo của tôi là thiết kế hệ thống tách phần phân tích tín hiệu khỏi phần trò chuyện, để chatbot dùng prompt ngắn gọn cho câu hỏi chung và chỉ gọi mô hình chuyên dụng khi thực sự cần tính toán phức tạp. Thừa nhận rằng công nghệ tốt nhất không có nghĩa là phù hợp nhất cho mọi tình huống là bước quan trọng trong sự phát triển của iCafeFX và SiamCafe.
Tôi vẫn tin vào sức mạnh của AI, nhưng phải học cách sử dụng nó một cách thông minh - không chỉ theo trend hay những con số đẹp trên màn hình. Sự thật phũ phàng nhất là: khách hàng không quan tâm mô hình của bạn đạt điểm bao nhiêu. Họ chỉ quan tâm liệu có nhận được câu trả lời đủ nhanh và đủ chính xác hay không. Việc tinh chỉnh hệ thống tiếp theo sẽ tập trung vào giảm latency làm ưu tiên số một, để công nghệ phục vụ con người chứ không phải con người chờ đợi công nghệ.