什么是本地 AI 模型,以及为什么我迁移到本地运行
我习惯用贴近生活的例子来解释技术问题。因为当人们提到"AI"时,很多人想到的是需要登录、联网、等待他人服务器处理的网页聊天机器人。
但本地 AI 模型意味着将这种合成智能直接放在我们自己的机器上,就像下载并安装应用程序,而不是通过浏览器打开网页使用。
我从 2026 年中开始认真这样做,因为反复遇到同样的问题:不确定的延迟、每月上涨的订阅费用,以及数据不知流向何方的担忧。
对比:云端大脑 vs 本地大脑
想象一下我们需要财务顾问的帮助。
云端模式就像打电话给远程专家,每次提问都要等待接通,必须重新解释情况,而且那位专家完全不记得我们的历史。
本地模式就像雇佣一位常驻顾问来我们办公室工作。他能看到所有文件,记住上下文,因为距离近所以响应快,最重要的是外部人员无法访问我们的数据。
从技术角度看,本地 LLM 模型是加载到我们机器内存中的数 GB 大小的权重文件(weights),然后通过推理引擎运行,如 llama.cpp、Ollama 或 LM Studio。
我在实验室中使用这三种工具,取决于工作负载。
我们在 iCafeFX 的配置
我们的系统由多层组成。
第一层是使用 C2 上 LiteLLM 的代理路由,它的职责是接收来自各种应用的请求,然后根据我们制定的策略转发给合适的模型。
第二层是实际运行模型的组件。我将工作负载分布到多台机器上。
Mac mini M4 通过 LM Studio/MLX 运行 7B-13B 模型,用于需要低延迟的一般推理任务。
i9 台式机(D:/models/)存储并运行 70B+ 参数的大型模型,用于微调(fine-tuning)和评估工作。
NAS(群晖)是权重文件、配置、日志和各种检查点的中央存储。
我们通过称为"fleet eval"的流水线测试每个新模型,该流水线让工件(artifacts)通过多个模型运行多轮,以客观比较输出质量。
切实可感的优势
响应速度是最明显的改善。当模型本地化后,延迟从 2-5 秒(云端)降低到中等规模模型不到 100 毫秒。
隐私对我们也很重要,因为我们处理交易数据、提示模板和策略文档,不希望任何人看到。
测试模型变体变得容易得多。我可以立即将新模型部署到测试机上,无需等待供应商批准或更新 API。
更重要的是成本可预测性。不再有因使用大量 token 而令人惊讶的月末账单。
许多人未提及的挑战
但本地 AI 并非易事。
资源管理是大问题。运行 70B 参数模型需要大量 RAM/VRAM。我多次遇到 OOM(内存不足)导致机器卡死的问题。
模型选择更像是艺术而非科学。没有单一模型在所有任务上都是最好的。模型 A 可能在任务 X 上表现良好,但在任务 Y 上可能比小一半的模型 B 更差。
维护基础设施需要有人持续更新驱动程序、CUDA 版本、容器镜像和安全补丁。
我曾遇到 GPU 驱动更新后推理速度下降 40% 且毫无警告的情况。
实验室案例:测试新模型
2026 年 9 月 15 日,我们测试下载并验证了 BF16 源格式的 709-L 模型。
流程是从 HuggingFace 下载、验证每个分片(shard)的校验和(13/13 个文件),然后复制到 i9 台式机的 D:/models/ 存储。
实际日志 [job#11901] 显示我们成功验证了 26 个文件,共 55.58GB,字节完全匹配 HuggingFace API。
随后 [job#11902] 进行工作交接至下一步:已验证 → 准备评估。
我们定期进行此类测试,因为需要确保生产环境中使用的模型仍按标准运行。
安全性:人们常忽略的问题
提到本地 AI,很多人想到的是速度和隐私,但安全性同样重要。
即使对本地模型,如果输入未正确清理,也可能发生提示注入攻击。
如果文件系统未受保护,模型权重文件本身也可能被篡改或伪造。
我们采用多层方法,包括文件权限、NAS 加密以及每次加载新模型时的校验和验证。
经验之谈
我想对正在考虑尝试本地 AI 的人说:
从小规模开始。在现代 GPU 机器上使用 7B 模型,然后逐步扩展。
不要期望本地能完全替代云端。某些任务仍需要运行在集群上的 400B+ 模型的算力。
投资监控和日志记录,因为随着系统变大,调试会困难得多。
最重要的是接受它会经常出故障的事实。我曾遇到推理引擎中的 bug,导致输出错误却没有任何错误信息。
未来展望
我认为本地 AI 将在未来 2-3 年内成为高级用户和小型企业的标准。
模型会更小但更强大,硬件会更便宜更快,工具链会更加成熟。
对于 iCafeFX 的我们来说,我们将不会停止测试和优化,因为我们相信边缘推理(在终端设备上运行 AI)是那些需要低延迟、高隐私和可预测成本的 AI 应用的未来。
如果你正在寻找由本地 AI 驱动的外汇工具,并且理解这些挑战,请查看 iCafeForex。我们为希望比使用一般云服务拥有更多控制权的交易者开发工具。开始使用
参考来源
- [job#12007] 从本地文件加载 token 并在开始前检查时间窗口(23:14 ICT)的作业日志
- [job#12005] 在原生 Mac 上启动舰队评估的日志(20 个工件 × 2 个模型 × 3 次重复)
- [job#11936] 处理作业交接并检查 NAS token 文件的预检日志
- [job#11935] AMD 本地机器为比较文件夹进行 WAV 组织干运行的日志
- [job#11902] 总结下载 709-L BF16 源文件并移交后续步骤的作业交接日志
- [job#11901] 验证日志,确认成功下载 709-L BF16 源文件(26 个文件,55.58GB,字节完全匹配)
想开设 XM Broker 交易账户?点击开户
我们真实系统的证据
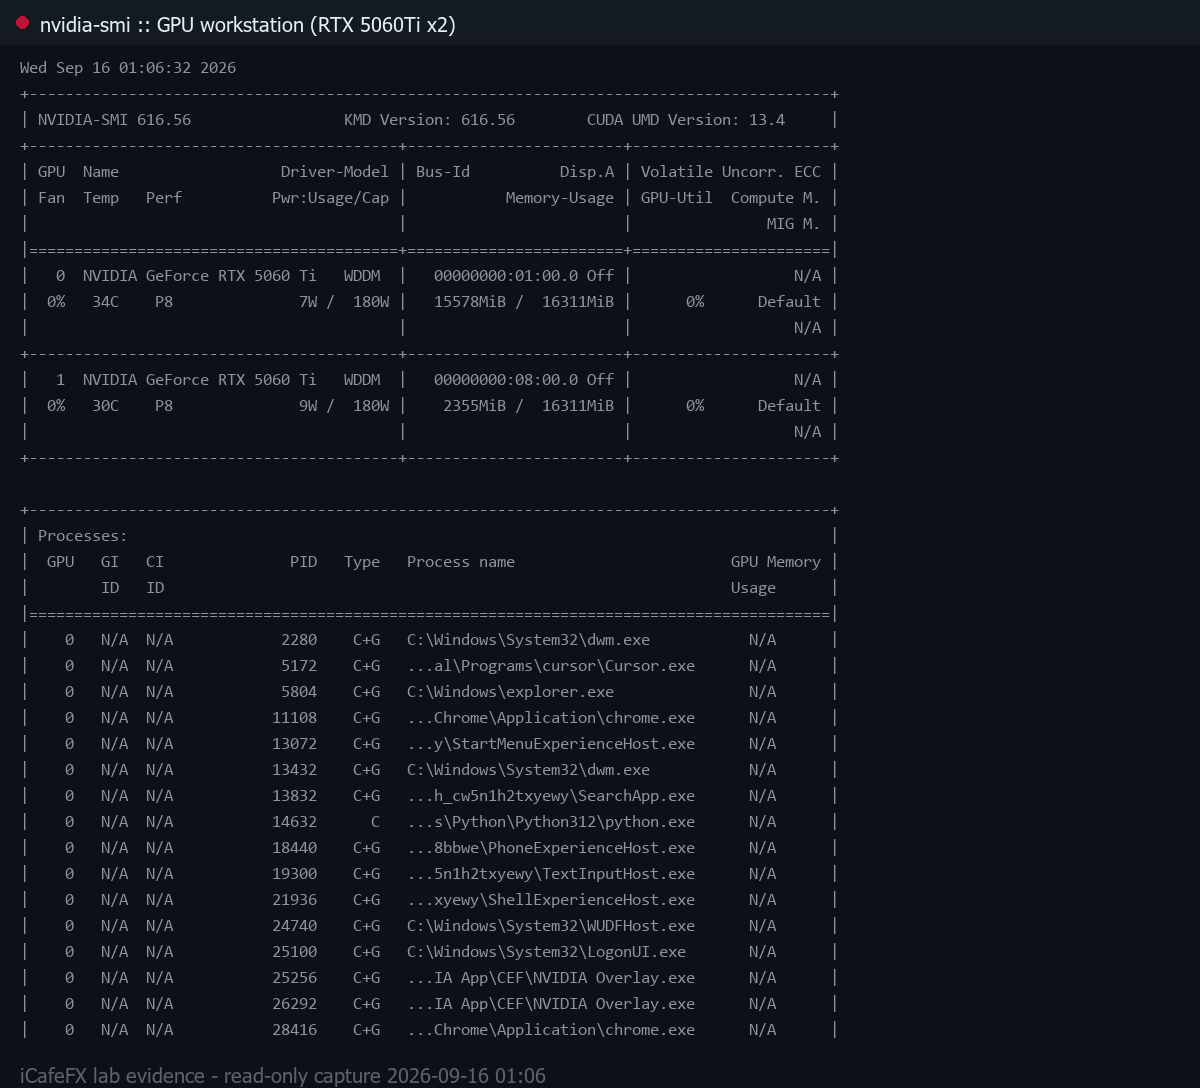
nvidia-smi on i9 (RTX 5060Ti x2) on 2026-09-16 while the system was burning hero images with FLUX
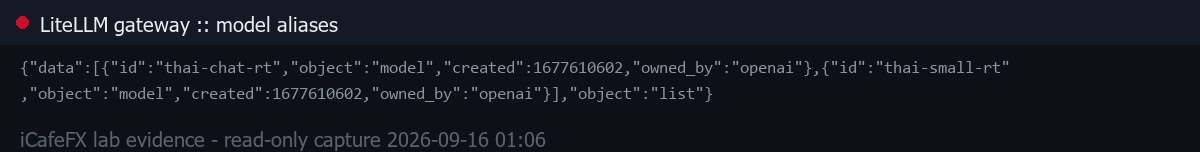
Model alias list on our LiteLLM gateway on 2026-09-16 (real curl)
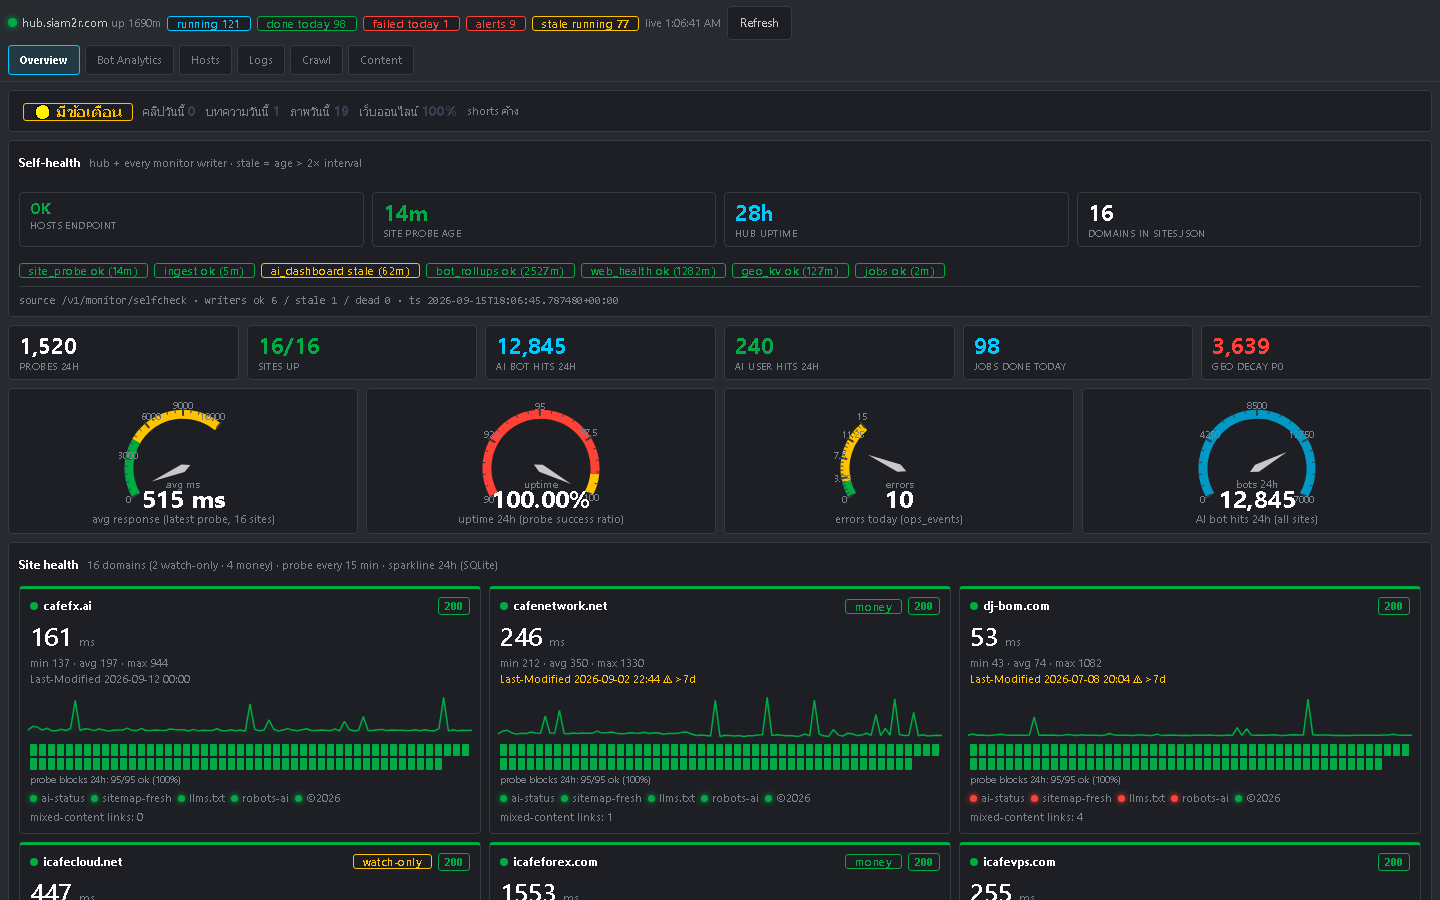
Our system hub monitor page on 2026-09-16 (real web and job status)
