로컬 AI 모델이란 무엇이며, 왜 저는 자신의 컴퓨터에서 실행하기로 했는가
기술적인 주제를 일상적인 비유로 설명하는 것을 좋아합니다. 사람들이 "AI"라고 말할 때, 많은 이들은 로그인하고 인터넷에 연결해야 하며 다른 사람의 서버가 작업을 처리하는 것을 기다려야 하는 웹 기반 챗봇을 떠올립니다.
그러나 로컬 AI 모델은 그 합성 두뇌를 우리 자신의 컴퓨터에 가져오는 것입니다. 브라우저를 통해 웹사이트를 여는 대신 앱을 다운로드하여 설치하는 것과 같습니다.
저는 2026년 중반부터 이 방식을 진지하게 사용하기 시작했습니다. 예측할 수 없는 레이턴시, 매달 오르는 구독료, 데이터가 어디로 유출되는지 알 수 없다는 우려 등 동일한 문제들을 반복해서 겪었기 때문입니다.
비교: 클라우드 위의 두뇌 vs 자신의 컴퓨터 위의 두뇌
재무 자문가의 도움이 필요하다고 상상해 보세요.
클라우드 방식은 원격 전문가에게 전화하는 것과 같습니다. 질문할 때마다 연결될 때까지 기다려야 하고, 매번 상황을 다시 설명해야 하며, 그 전문가는 우리의 이력을 전혀 기억하지 못합니다.
로컬 방식은 상주 자문가를 고용하여 우리 사무실에서 일하게 하는 것과 같습니다. 그는 모든 문서를 보고, 맥락을 기억하며, 가까이 있기 때문에 빠르게 응답합니다. 무엇보다도 외부인이 우리의 데이터에 접근할 수 없습니다.
기술적으로 로컬 LLM 모델은 수 기가바이트의 가중치(weights) 파일로, 우리 컴퓨터의 메모리에 로드된 후 llama.cpp, Ollama, LM Studio 같은 추론 엔진을 통해 실행됩니다.
저는 워크로드에 따라 이 세 가지 모두를 랩에서 사용합니다.
iCafeFX의 설정
우리의 시스템은 여러 레이어로 구성됩니다.
첫 번째 레이어는 C2에서 LiteLLM을 사용하는 프록시 라우팅입니다. 그 역할은 다양한 앱으로부터 요청을 받아 우리가 정의한 정책에 따라 적절한 모델로 전달하는 것입니다.
두 번째 레이어는 모델을 실제로 실행하는 부분입니다. 저는 워크로드를 여러 머신에 분산합니다.
Mac mini M4는 LM Studio/MLX를 통해 7B-13B 모델을 실행하며, 낮은 레이턴시가 필요한 일반적인 추론 작업에 사용됩니다.
i9 데스크톱(D:/models/)은 70B+ 파라미터의 더 큰 모델을 저장하고 실행하며, 파인튜닝 및 평가 작업에 사용됩니다.
NAS(Synology)는 가중치 파일, 설정, 로그, 다양한 체크포인트를 위한 중앙 저장소입니다.
우리는 모든 새 모델을 "플릿 평가(fleet eval)"라고 불리는 파이프라인을 통해 테스트합니다. 이는 여러 모델에서 여러 번 아티팩트를 실행하여 출력 품질을 객관적으로 비교하는 것입니다.
실제로 체감할 수 있는 장점
응답 속도가 가장 명확하게 체감되는 부분입니다. 모델이 로컬에 있으면, 중형 모델의 경우 레이턴시가 2-5초(클라우드)에서 100밀리초 미만으로 줄어듭니다.
프라이버시도 우리에게 매우 중요합니다. 우리는 누구에게도 보여주고 싶지 않은 트레이딩 데이터, 프롬프트 템플릿, 전략 문서를 다루기 때문입니다.
모델 변형 테스트가 훨씬 쉬워졌습니다. 벤더의 승인이나 API 업데이트를 기다릴 필요 없이 새 모델을 즉시 테스트 머신에 배포할 수 있습니다.
무엇보다 비용 예측 가능성이 중요합니다. 토큰을 많이 사용해서 놀라운 청구서가 도착하는 일이 없습니다.
많은 사람이 언급하지 않는 도전 과제
그러나 로컬 AI는 쉬운 일이 아닙니다.
리소스 관리가 큰 문제입니다. 70B 파라미터 모델을 실행하려면 많은 RAM/VRAM이 필요합니다. OOM(메모리 부족)으로 인해 시스템이 멈추는 문제를 여러 번 겪었습니다.
모델 선택은 과학보다 예술에 가깝습니다. 모든 작업에서 가장 좋은 단일 모델은 존재하지 않습니다. 모델 A는 작업 X를 잘할 수 있지만, 작업 Y에서는 절반 크기의 모델 B보다 나쁠 수 있습니다.
인프라 유지보수는 누군가가 드라이버, CUDA 버전, 컨테이너 이미지, 보안 패치를 업데이트해야 합니다.
GPU 드라이버 업데이트 후 추론 속도가 40%나 떨어졌는데 전혀 경고가 없었던 경우가 있었습니다.
랩에서의 예시: 새 모델 테스트
2026년 9월 15일, 우리는 709-L 모델의 BF16 소스 형식을 다운로드하고 검증하는 것을 테스트했습니다.
과정은 HuggingFace에서 다운로드, 모든 샤드의 체크섬 검증(13/13 파일), 그리고 i9 데스크톱의 D:/models/로 복사하는 것입니다.
실제 로그 [job#11901]에 따르면, 우리는 26개 파일, 총 55.58GB를 바이트 단위 정확도로 검증에 성공했으며, 이는 HuggingFace API와 일치합니다.
이후 [job#11902]는 다음 단계로 작업 인수를 수행했습니다: VERIFIED → READY FOR EVALUATION
이러한 테스트는 정기적으로 수행됩니다. 프로덕션에서 사용되는 모델이 여전히 표준에 맞게 작동한다는 보장을 원하기 때문입니다.
보안: 사람들이 종종 잊어버리는 부분
로컬 AI를 언급할 때, 많은 사람은 속도와 프라이버시에 대해 생각합니다. 그러나 보안도同等하게 중요합니다.
프롬프트 인젝션 공격은 입력이 제대로 정제되지 않으면 로컬 모델에서도 발생할 수 있습니다.
모델 가중치 파일 자체도 파일시스템이 보안되지 않으면 수정되거나 위조될 수 있습니다.
우리는 파일 권한, NAS 암호화, 새 모델을 로드할 때마다 체크섬 검증 등 여러 레이어의 접근 방식을 사용합니다.
경험에서 얻은 교훈
로컬 AI를 시도해보려는 사람들에게 말하고 싶은 것이 있습니다.
작게 시작하세요. 현대적인 GPU가 있는 머신에서 7B 모델을 사용하고, 점차 확장하세요.
로컬이 클라우드를 완전히 대체할 것이라고 기대하지 마세요. 일부 작업은 여전히 클러스터에서 실행되는 400B+ 모델의 성능이 필요합니다.
모니터링과 로깅에 투자하세요. 시스템이 커질수록 디버깅이 훨씬 어려워집니다.
가장 중요한 것은 이것이 자주 깨진다는 것을 받아들이는 것입니다. 에러 메시지 없이 출력을 잘못 생성하는 추론 엔진의 버그를 발견한 적이 있습니다.
앞으로의 방향
저는 로컬 AI가 2-3년 내에 파워 유저와 중소기업의 표준이 될 것이라고 봅니다.
모델은 더 작아지되 더 강력해지고, 하드웨어는 더 저렴하고 빨라지며, 툴링은 더 성숙해질 것입니다.
iCafeFX의 우리는 테스트와 최적화를 멈추지 않을 것입니다. 왜냐하면 에지 추론(엔드 디바이스에서 AI 실행)이 낮은 레이턴시, 높은 프라이버시, 예측 가능한 비용이 필요한 AI 애플리케이션의 미래라고 믿기 때문입니다.
로컬 AI 기반의 포렉스 도구를 찾고 있고 이러한 도전 과제를 이해하신다면, iCafeForex를 확인해 보세요. 우리는 일반적인 클라우드 서비스를 사용하는 것보다 더 많은 제어를 원하는 트레이더들을 위한 도구를 개발합니다. 시작하기
참고 자료/출처
- [job#12007] 로컬 파일에서 토큰을 로드하고 실행 전 시간 창(23:14 ICT)을 확인하는 작업의 로그
- [job#12005] Mac raw에서 20개 아티팩트 x 2개 모델 x 3회 반복의 플릿 평가 실행 로그
- [job#11936] 작업 인수를 처리하고 NAS 토큰 파일을 확인하는 사전 검사 로그
- [job#11935] 폴더 비교를 위한 WAV 조직화 드라이런을 수행한 AMD 로컬 머신의 로그
- [job#11902] 709-L BF16 소스 다운로드를 요약하고 다음 단계로 전달하는 작업 인수 로그
- [job#11901] 709-L BF16 소스가 26개 파일, 55.58GB로 바이트 단위 정확도로 성공적으로 다운로드되었음을 확인하는 검증 로그
XM 브로커와 함께 트레이딩 계좌를 개설하고 싶으신가요? 계좌 개설 클릭
실제 시스템의 증거
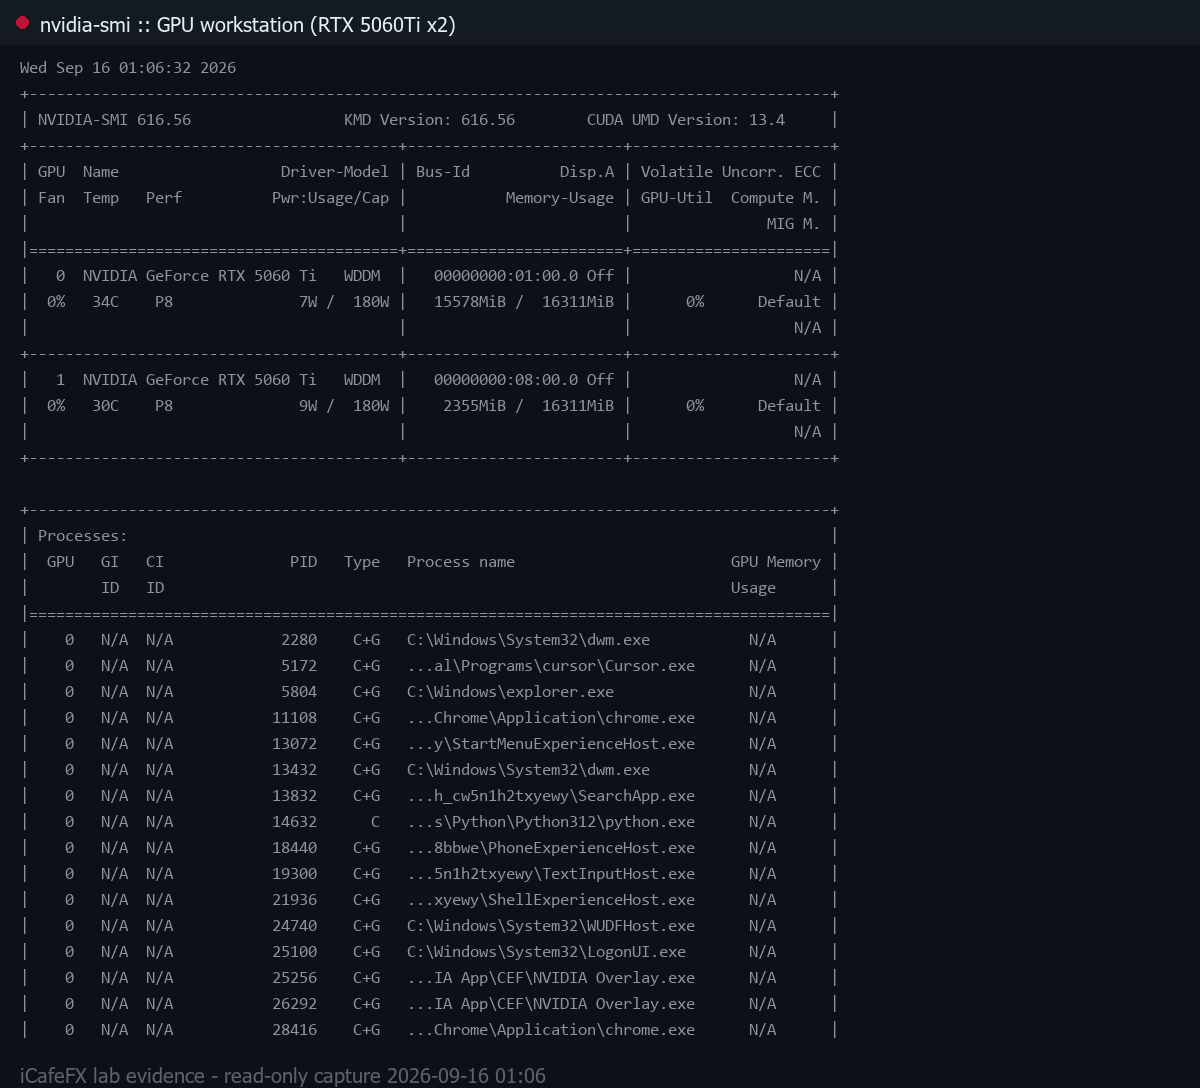
nvidia-smi on i9 (RTX 5060Ti x2) dated 2026-09-16 while system was burning hero image with FLUX
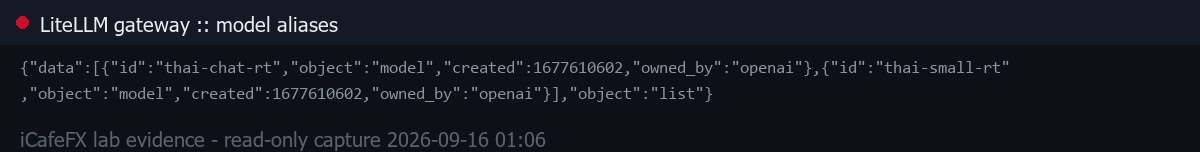
Our LiteLLM gateway's model alias list dated 2026-09-16 (real curl)
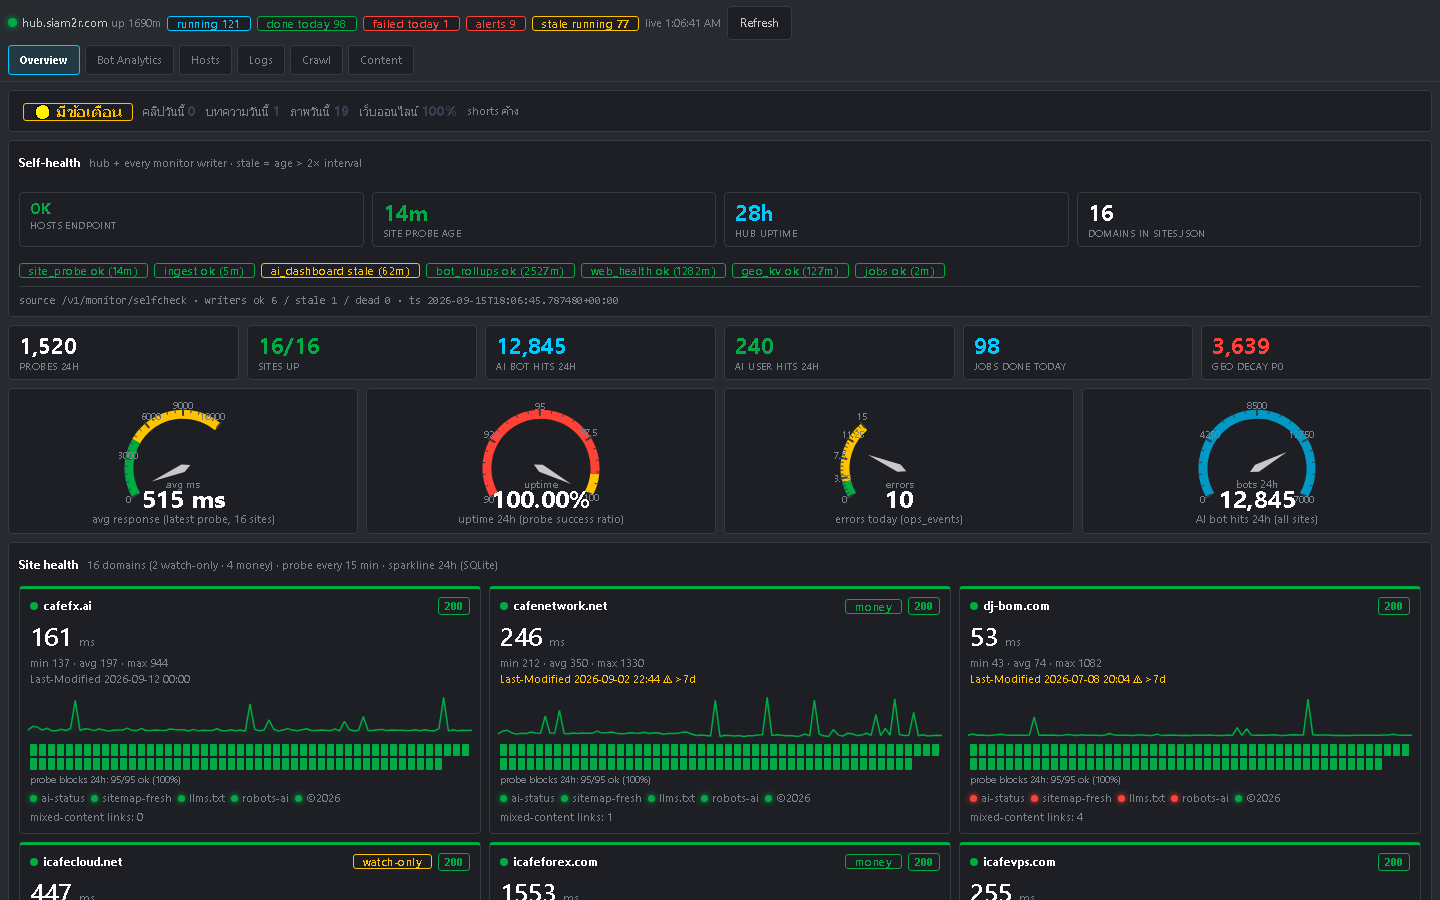
Our system hub's monitor page dated 2026-09-16 (real web and job status)
