ローカルAIモデルとは何か、そしてなぜ私は自分のマシンで実行するようになったのか
私は技術的な話題を身近な例で説明するのが好きです。人々が「AI」と言うと、ログインが必要でネット接続が必要で、他人のサーバーが処理してくれるウェブチャットボットを思い浮かべるからです
しかしローカルAIモデルとは、その合成脳を私たちのマシン上に置くことです。ウェブブラウザでサイトを開いて使う代わりに、アプリをダウンロードしてインストールするのと同じです
私は2026年半ばにこれを本格的に始めました。予測できないレイテンシ、毎月上がるサブスクリプション料金、データがどこへ漏れるか分からないという不安など、同じ問題に何度も直面したからです
比較:クラウド上の脳 vs 自分のマシン上の脳
財務アドバイザーの助けが必要だと想像してください
クラウド型は遠隔の専門家に電話するのと同じです。質問するたびに電話がつながるのを待ち、状況を毎回説明し直さなければなりません。そしてその専門家は私たちの履歴を覚えていません
ローカル型は専任のアドバイザーをオフィスに雇うのと同じです。彼はすべての書類を見ることができ、文脈を覚えており、近くにいるので素早く応答できます。そして何より重要なのは、外部の誰も私たちのデータにアクセスできないことです
技術的な観点から言えば、ローカルLLMモデルとは、数ギガバイトの重みファイル(weights)が私たちのマシンのメモリに読み込まれ、llama.cpp、Ollama、LM Studioなどの推論エンジンで実行されるものです
私はラボでこの3つすべてを使用しており、ワークロードによって使い分けています
iCafeFXでの私たちのセットアップ
私たちのシステムは複数のレイヤーで構成されています
最初のレイヤーはC2上のLiteLLMを使用したプロキシルーティングです。その役割は、さまざまなアプリからのリクエストを受け取り、私たちが設定したポリシーに基づいて適切なモデルに転送することです
2番目のレイヤーは実際のモデル実行部分です。私はワークロードを複数のマシンに分散させています
Mac mini M4はLM Studio/MLXを通じて7B-13Bのモデルを実行し、低レイテンシが必要な一般的な推論タスクに対応しています
i9デスクトップ(D:/models/)は70B+パラメータのより大きなモデルを保存・実行し、ファインチューニングや評価タスクに対応しています
NAS(Synology)は重みファイル、設定、ログ、さまざまなチェックポイント用の中央ストレージです
新しいモデルはすべて「フリートエバリュエーション」と呼ばれるパイプラインを通じてテストされます。これはアーティファクトを複数のモデルで複数回実行し、出力品質を客観的に比較するものです
実感できる利点
応答速度は最も顕著な改善点です。モデルがローカルにあることで、レイテンシはクラウドの2-5秒から中規模モデルで100ミリ秒未満に減少しました
プライバシーも私たちにとって非常に重要です。取引データ、プロンプトテンプレート、誰にも見られたくない戦略文書を扱っているからです
モデルバリアントのテストがはるかに容易になりました。新しいモデルをテストマシンに即座にデプロイでき、ベンダーの承認やAPI更新を待つ必要がありません
そして何より重要なのはコストの予測可能性です。トークンを大量に使用したことで月末に驚くような請求書が来ることがありません
多くの人が言及しない課題
しかしローカルAIは簡単なものではありません
リソース管理は大きな問題です。70Bパラメータのモデルを実行するには大量のRAM/VRAMが必要です。OOM(メモリ不足)でマシンがフリーズする問題に何度も遭遇しました
モデル選択は科学というより芸術です。すべてのタスクで最高のモデルは存在しません。モデルAはタスクXでは優れていても、タスクYでは半分以下のサイズのモデルBよりも劣る可能性があります
インフラの維持には、ドライバー、CUDAバージョン、コンテナイメージ、セキュリティパッチを更新する誰かが必要です
GPUドライバーの更新で推論速度が40%も低下し、警告もなかったという事態に遭遇したことがあります
ラボからの例:新モデルのテスト
2026年9月15日、私たちは709-LモデルのBF16ソース形式でのダウンロードと検証をテストしました
プロセスはHuggingFaceからのダウンロード、すべてのシャード(13/13ファイル)のチェックサム検証、そしてi9デスクトップのD:/models/へのコピーです
実際のログ[job#11901]によると、私たちはHuggingFace APIとバイト単位で一致する26ファイル(合計55.58GB)の検証に成功しました
その後[job#11902]は次のステップへのジョブ引き継ぎを行いました。VERIFIED → READY FOR EVALUATIONです
このようなテストは定期的に実施しています。プロダクションで使用しているモデルが依然として基準通りに動作しているという保証が必要だからです
セキュリティ:人々がしばしば忘れること
ローカルAIについて話すとき、多くの人は速度とプライバシーについて考えますが、セキュリティも同等に重要です
プロンプトインジェクション攻撃は、入力が適切にサニタイズされていない場合、ローカルモデルでも発生する可能性があります
モデルの重みファイル自体も、ファイルシステムが保護されていなければ改ざんや偽造される可能性があります
私たちはファイルパーミッション、NAS暗号化、新しいモデルをロードするたびにチェックサム検証を行うという多層的なアプローチを使用しています
経験からの教訓
ローカルAIを試すことを検討している人たちに伝えたいのは
小さく始めることです。現代のGPUを搭載したマシンで7Bモデルを使用し、それから徐々にスケールアップしてください
ローカルがクラウドを完全に置き換えることを期待しないでください。一部のタスクは依然としてクラスタ上で実行される400B+モデルのパワーを必要としています
モニタリングとロギングに投資してください。システムが大きくなると、デバッグははるかに難しくなります
そして最も重要なのは、これが頻繁に壊れることを受け入れることです。エラーメッセージもなく出力を間違える推論エンジンのバグに遭遇したことがあります
今後の展望
私はローカルAIが、今後2-3年でパワーユーザーと中小企業にとっての標準になると見ています
モデルは小さくなりながらより賢くなり、ハードウェアは安くて速くなり、ツールはより成熟していきます
iCafeFXの私たちにとって、テストと最適化を止めることはありません。エッジ推論(端末デバイスでのAI実行)が、低レイテンシ、高プライバシー、予測可能なコストを必要とするAIアプリケーションの未来であると信じているからです
ローカルAIで駆動され、これらの課題を理解しているフォレックスツールをお探しなら、iCafeForexをご覧ください。私たちは一般的なクラウドサービスよりも制御を重視するトレーダーのためのツールを開発しています始める
参考資料/出典
- [job#12007] ローカルファイルからトークンをロードし、実行前に時間ウィンドウ(23:14 ICT)を確認するジョブのログ
- [job#12005] Mac raw上で20アーティファクト x 2モデル x 3反復のフリート評価を起動するログ
- [job#11936] ジョブ引き継ぎを処理しNASトークンファイルを確認するプレフライトチェックのログ
- [job#11935] フォルダ比較用のWAV整理のドライランを行うAMDローカルマシンのログ
- [job#11902] 709-L BF16ソースのダウンロードを要約し次のステップに引き継ぐジョブ引き継ぎログ
- [job#11901] 709-L BF16ソースが26ファイル55.58GBでバイト単位一致でダウンロード成功したことを確認する検証ログ
XM Brokerで取引口座の開設に興味がありますか?クリックして口座を開設
私たちの実際のシステムからの証拠
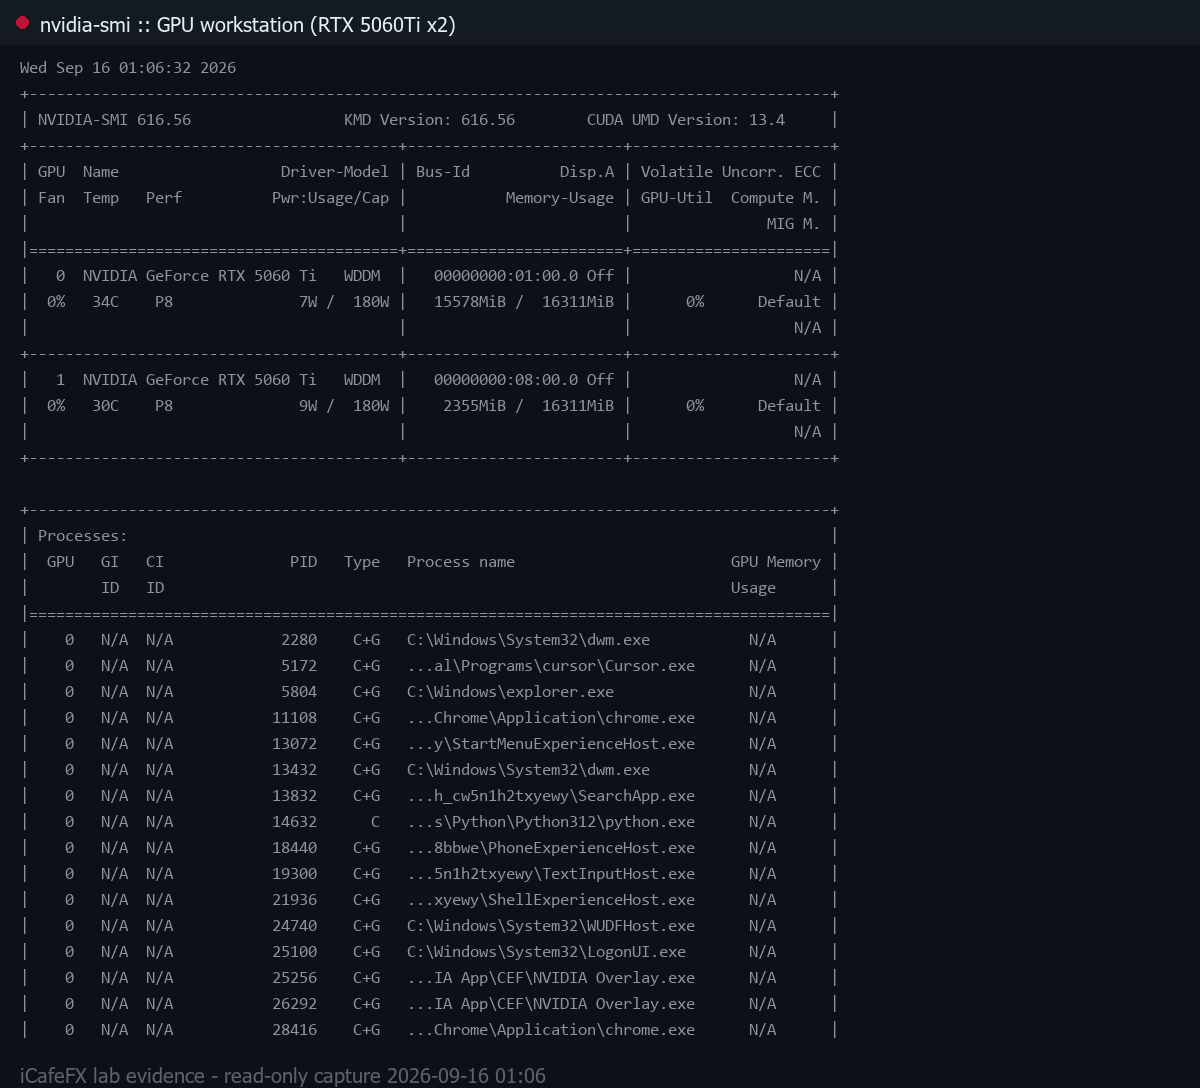
nvidia-smi on i9 (RTX 5060Ti x2) on 2026-09-16 while system was burning hero image with FLUX
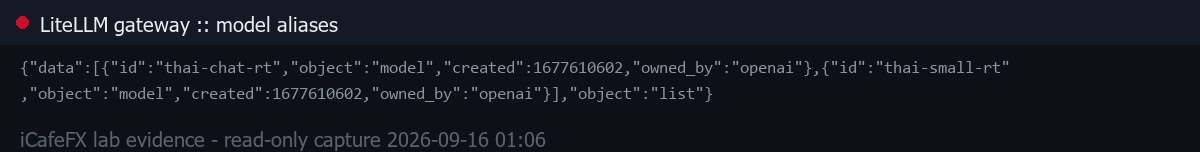
Model alias list on our LiteLLM gateway on 2026-09-16 (actual curl)
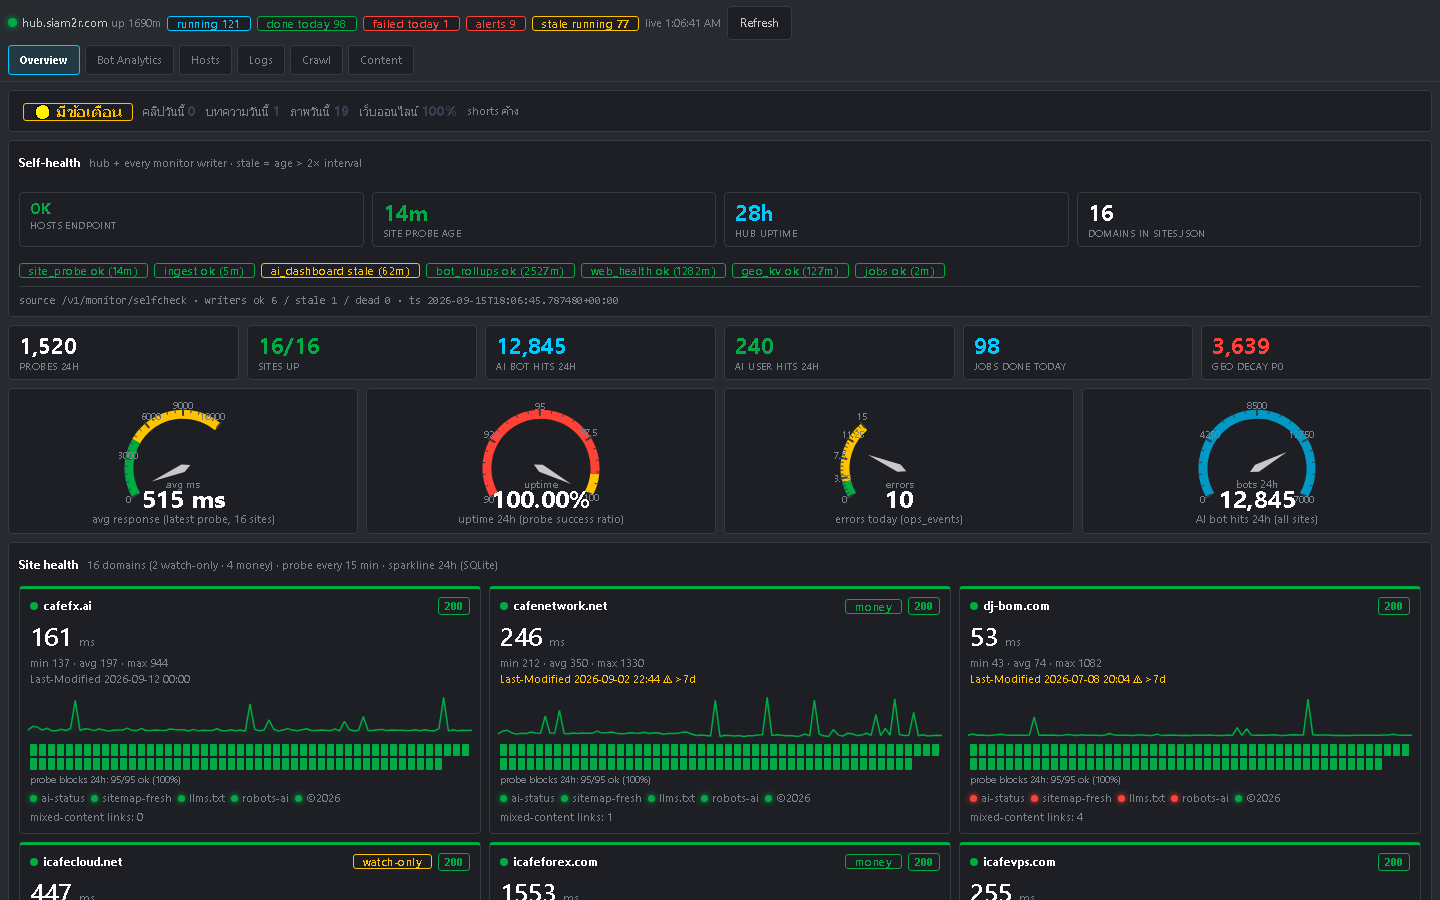
Our system hub monitor page on 2026-09-16 (actual web and job status)
