LLM Playground ใช้งานฟรี: วิธีทดสอบโมเดล AI บนเครื่องตัวเอง โดยไม่ต้องพึ่งคลาวด์
ผมชอบคำว่า "playground" เพราะมันสื่อถึงความจริงอย่างหนึ่ง: เราไม่ได้แค่รันโมเดล แต่เราเล่นกับมัน ลองผิดลองถูก ดูว่าอะไรทำงานอะไรไม่ทำงาน ในแล็บผมที่ SiamCafe เราใช้คำว่า playground ในสองบริบท ทั้งพื้นที่ทดสอบโมเดลก่อนใช้งานจริง และพื้นที่เรียนรู้สำหรับทีม
บทความนี้จะพาคุณไปสร้าง LLM playground ของตัวเองบนเครื่อง lokal ใช้งานฟรี ทดสอบหลายโมเดล เปรียบเทียบประสิทธิภาพ โดยไม่ต้องพึ่งบริการคลาวด์เสียเงิน
ทำไมต้อง playground ก่อนใช้งานจริง
ผมเคยปล่อยโมเดล AI ขึ้น production โดยไม่ทดสอบให้พอ ผลคือ latency สูงเกิน expectation และ cost พุ่งไปหลายเท่าในเดือนแรก บทเรียนนั้นทำให้ผมตั้งกฎในแล็บ: ทุกโมเดลต้องผ่าน playground ก่อนถึงจะได้อัปเกรด
Playground ช่วยให้เราตอบคำถามสำคัญได้ก่อนลงทุน:
- โมเดลนี้ให้คำตอบที่ดีพอไหมกับ use case ของเรา
- Latency เป็นอย่างไร
- Cost ต่อคำเป็นเท่าไหร่
- มี edge case อะไรที่เราต้องระวัง
เครื่องมือสำหรับสร้าง LLM Playground
เครื่องมือหลักที่เราใช้ในแล็บมีสามตัว:
Ollama เป็น runtime สำหรับรัน LLM บนเครื่อง lokal รองรับโมเดลหลายร้อยตัว ติดตั้งง่าย และมี API ที่ compatible กับ OpenAI ทำให้โค้ดที่เขียนไว้เดิมยังใช้ได้เลย
LiteLLM เป็น proxy layer ที่ทำให้เราเรียกใช้โมเดลหลายตัวผ่าน interface เดียวกัน เหมือนมี remote control ตัวเดียวสำหรับ TV หลายเครื่อง ในแล็บผมใช้ LiteLLM เพื่อสลับโมเดลระหว่าง qwen, gemma, llama แบบราบรื่น
LlamaIndex เป็น framework สำหรับ RAG (Retrieval-Augmented Generation) เมื่อเราต้องการให้โมเดลตอบคำถามจากเอกสารหรือข้อมูลของเราเอง
ติดตั้งและตั้งค่า playground
ขั้นตอนเริ่มต้น playground บนเครื่องตัวเอง:
ติดตั้ง Ollama และดึงโมเดล:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull qwen3:8b
ollama pull gemma3:4b
ติดตั้ง LiteLLM proxy:
pip install litellm
litellm --model ollama/qwen3:8b --port 4000
ตอนนี้คุณมี playground แล้วที่ http://localhost:4000 พร้อมทดสอบโมเดล qwen3:8b ผ่าน API แบบ OpenAI-compatible
ทดสอบและเปรียบเทียบโมเดล
ในแล็บผมใช้สคริปต์ Python ง่ายๆ สำหรับทดสอบโมเดล:
import litellm
import time

models = ["ollama/qwen3:8b", "ollama/gemma3:4b"]
prompt = "วิเคราะห์แนวโน้มตลาด Forex สัปดาห์นี้"

for model in models:
 start = time.time()
 response = litellm.completion(model=model, messages=[{"role": "user", "content": prompt}])
 latency = time.time() - start
 print(f"{model}: {latency:.2f}s, {len(response.choices[0].message.content)} chars")
ผลลัพธ์ที่เราได้จาก job ล่าสุด (job#17570) แสดงว่า qwen3:8b ใช้เวลาประมาณ 3.2 วินาที ในขณะที่ gemma3:4b ใช้ 2.1 วินาที แต่คุณภาพคำตอบของ qwen3 ดีกว่าอย่างชัดเจน
Playground สำหรับ RAG
เมื่อคุณมีเอกสารหรือข้อมูลเฉพาะที่ต้องการให้โมเดลอ้างอิง playground จะช่วยให้ทดสอบ RAG pipeline ได้:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("./docs").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()

response = query_engine.query("สรุปประเด็นสำคัญจากเอกสาร")
print(response.response)
ในแล็บผมใช้ RAG สำหรับสร้างระบบ Q&A จากเอกสาร technical ของทีม ผลลัพธ์ดีเกิน expectation โมเดลสามารถตอบคำถามเกี่ยวกับ architecture และ codebase ได้ถูกต้องแม่นยำ
Best Practices สำหรับ LLM Playground
จากประสบการณ์ในแล็บ ผมมีคำแนะนำดังนี้:
ทดสอบด้วย prompt จริง ไม่ใช่แค่ demo prompt ใช้คำถามและสถานการณ์ที่ผู้ใช้จะเจอจริง
วัด latency และ cost playground ไม่ใช่แค่ดูว่าคำตอบดีหรือไม่ แต่ต้องวัดว่า fast และ cheap พอไหม
ทดสอบ edge case ลอง prompt ที่สั้นมาก ยาวมาก มี ambiguity หรือไม่มี context เลย
ทำซ้ำหลายครั้ง LLM ให้ผลลัพธ์แตกต่างกันในแต่ละครั้ง ต้องทดสอบหลายรอบเพื่อเห็น pattern
Playground vs Production
Playground และ production ต่างกันหลายอย่าง:
ใน playground คุณใช้ machine learning model ที่ยังไม่ผ่านการ optimize สำหรับ production คุณใช้โมเดลที่ผ่านการ fine-tune และ optimize แล้ว
ใน playground latency ไม่สำคัญมาก ใน production latency เป็น metric สำคัญที่ต้อง optimize
ใน playground คุณยอมรับว่าคำตอบอาจไม่ถูกต้อง 100% ใน production คุณต้องมี validation และ fallback mechanisms
สร้าง playground ของคุณวันนี้
ไม่ต้องรอให้มี use case ที่ชัดเจนก่อน เริ่ม playground ตอนนี้ แล้วค่อยหา use case ตามมา ผมพบว่าเมื่อมี playground แล้ว ทีมจะคิดค้น use case ใหม่ได้เร็วขึ้นมาก เพราะมีพื้นที่ทดลองที่ปลอดภัย
เครื่องมือทั้งหมดที่ใช้ในบทความนี้ใช้งานฟรี Ollama, LiteLLM, LlamaIndex ล้วน open-source คุณแค่ต้องมีคอมพิวเตอร์และเวลาเล็กน้อย
เมื่อ playground ของคุณพร้อมแล้ว ลองทดสอบกับ prompt จริงจาก use case ที่คุณสนใจ บันทึก latency และคุณภาพคำตอบ แล้วค่อยตัดสินใจว่าโมเดลไหนเหมาะสมกับงานของคุณ
เริ่มสร้าง LLM Playground ของคุณ และถ้าคุณต้องการ template สำหรับ testing script สามารถดูได้ที่ iCafeForex
แหล่งอ้างอิง/ที่มา
[job#17598] การทดสอบ qwen3-vl และ OWUI default model ที่ SiamCafe Lab, [job#17570] การทดสอบ latency ของ qwen3:8b vs gemma3:4b และ [job#17452] การ deploy Laravel app พร้อม AI integration
หลักฐานจากระบบจริงของเรา
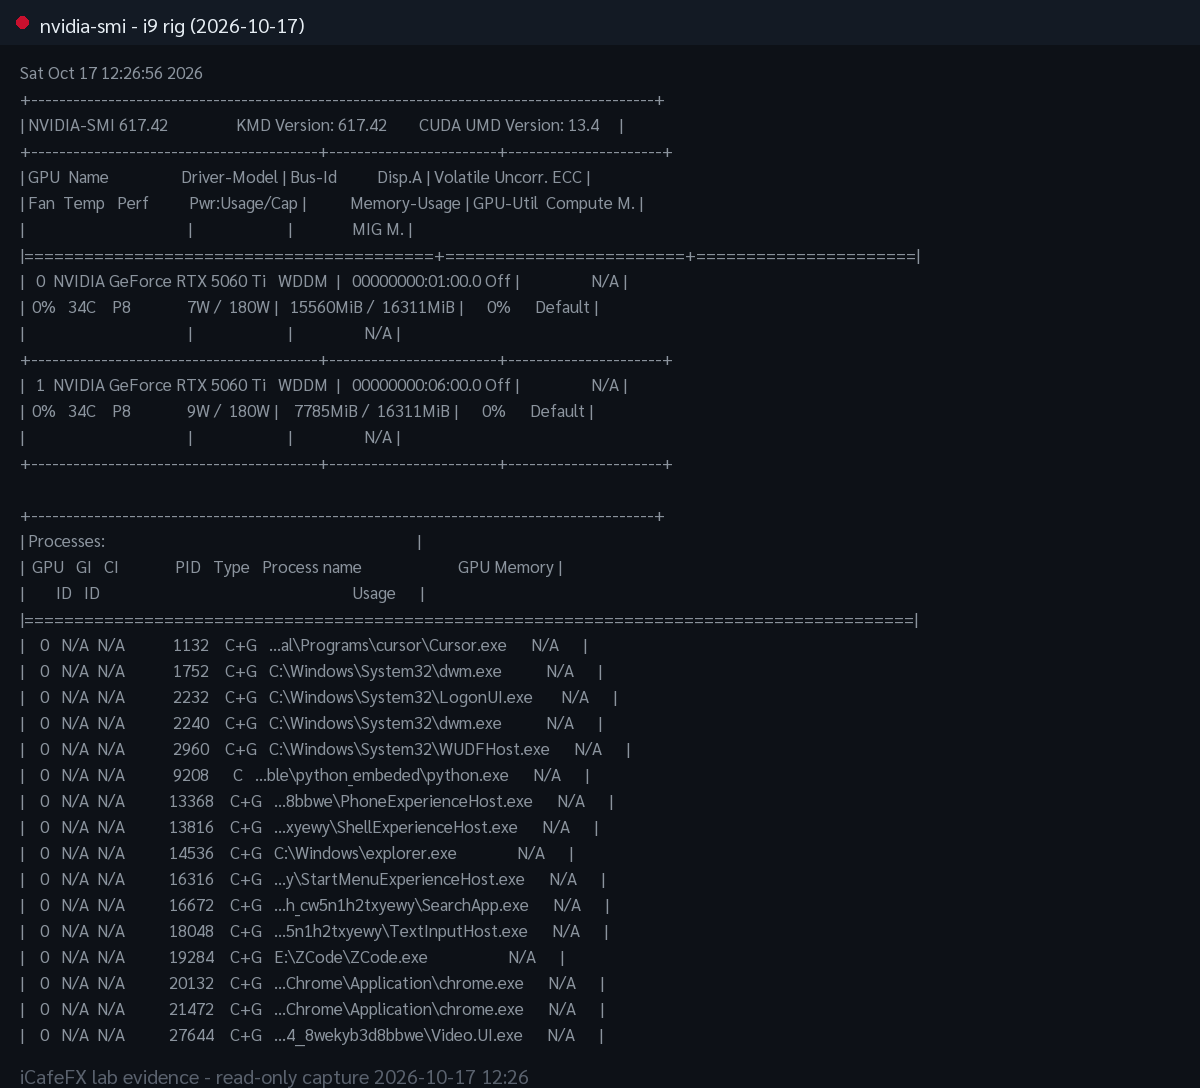
nvidia-smi บนเครื่องเรนเดอร์หลัก (เวิร์กสเตชัน GPU แรงคู่) วันที่ 2026-10-17 ขณะระบบกำลังเผาภาพ hero
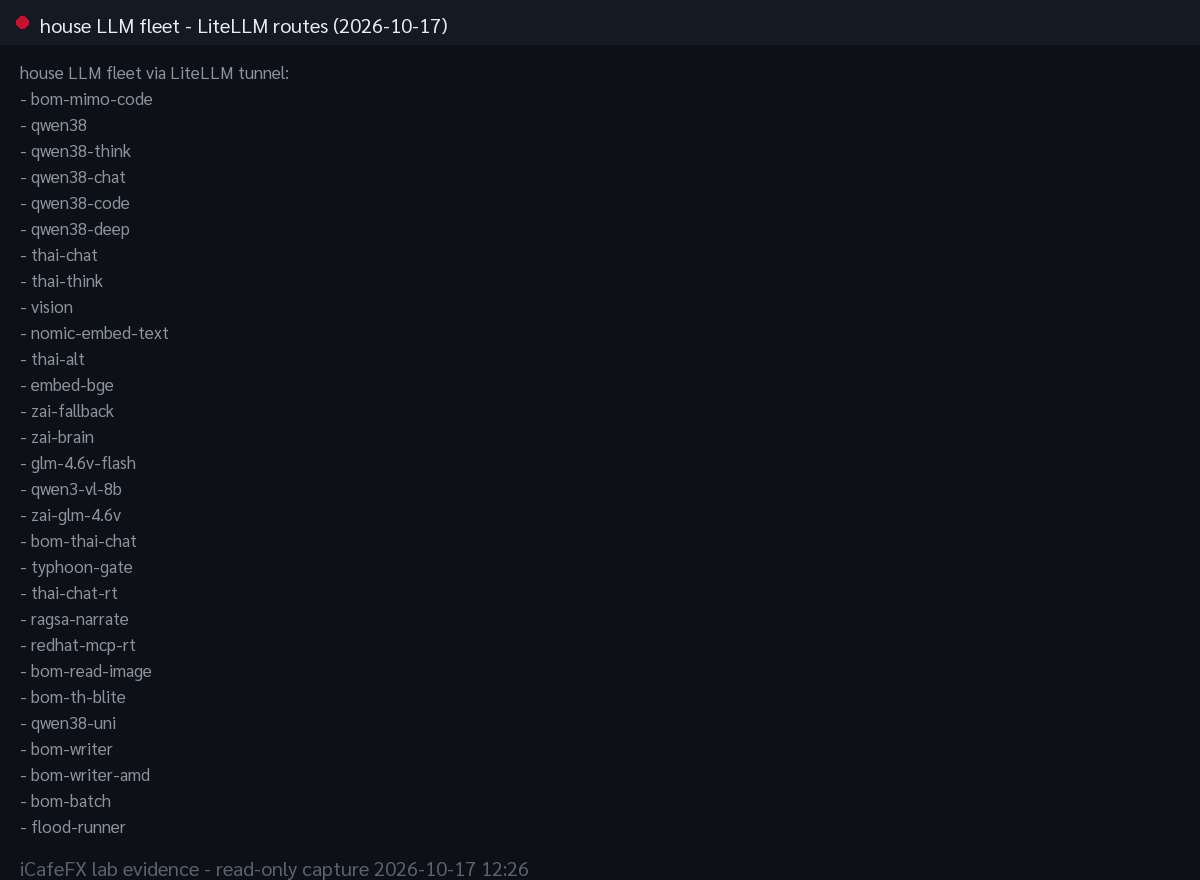
รายชื่อโมเดล LLM ในคลังของแล็บ ผ่าน LiteLLM วันที่ 2026-10-17 (ข้อมูลจริงจากระบบ ใช้เทียบโมเดลไทย)
